$ run polar_expedition --model=deepseek-r1
deepseek
极地科考探险 · 求索之路 - 探索未至之境
纯强化学习涌现,以极地科考般的坚毅探索智能边界
DeepSeek-R1 突破了传统依赖海量标注监督微调(SFT)的路径依赖,直接在超大规模强化学习演化中激发完整的长思维链。在解决国际数理奥赛难题、系统级高并发代码排障与跨领域前沿探索时,模型能够主动推翻错漏假设,进行深度自我纠偏。
结合 MLA(Multi-head Latent Attention)低秩注意力与独创的动态细粒度 MoE 稀疏路由,大幅精简显存开销与带宽损耗,以颠覆行业的普惠成本实现前沿闭源旗舰水准。
| 基准测试 / 评估维度 | DeepSeek - 探索未至之境 | 国际闭源顶尖模型 Alpha | 主流开源基线模型 Beta | 传统行业商用模型 Gamma |
|---|---|---|---|---|
| AIME 2024 (数学竞赛推演) | 79.8% (Pass@1) | 79.2% | 39.6% | 24.5% |
| MATH-500 (纯数理难题解题率) | 97.3% | 96.4% | 77.3% | 58.0% |
| Codeforces (专业算法竞技评分) | 2029 (Percentile 96.3%) | 1876 | 1245 | 960 |
| MMLU-Pro (高阶跨学科综合能力) | 84.0% | 84.4% | 75.2% | 62.8% |
| SWE-bench Verified (软件代码工程实测) | 49.2% | 48.9% | 38.8% | 27.0% |
01. MLA 低秩键值压缩
将推理显存占用缩减至常规方案十分之一,支持超高并发长文档连续对话与代码上下文延伸。
02. 稀疏细粒度专家路由
总计数百亿激活参数配合智能动态分工,在保障逻辑深度的同时达成高吞吐流式响应。
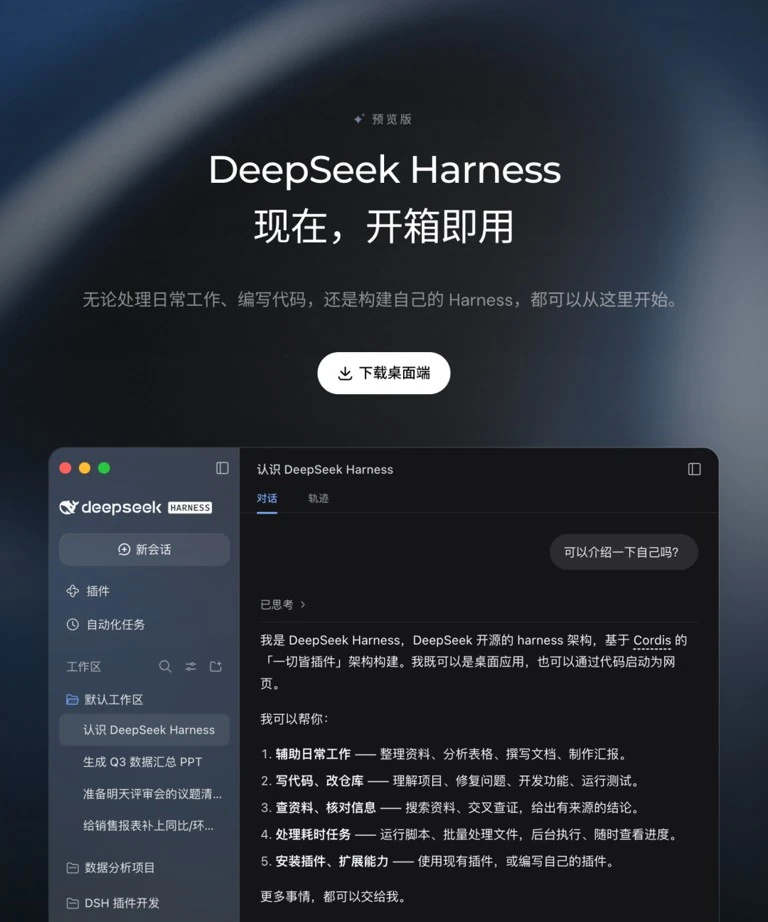
03. DeepSeek Harness 开源评测套件
基准评测脚本与 Prompt 全量公开,支持全球研究机构与工程师在客观公正环境下严格复现成绩。